Rencontre SERIQ
Rentrée SERIQ
jeudi 29 octobre 2026
- Heure
- de 16 h à 20 h
- Lieu
- Université de Montréal,
Pavillon Jean-Coutu, local S-1-111 - Langue
- Bilingue (français et anglais)
La rentrée de SERIQ a eu lieu le 29 octobre 2026 et a réuni une centaine de personnes. Nous remercions chaleureusement toutes celles et ceux qui y ont participé. Les photos seront publiées prochainement.
SERIQ élargit le réseau de recherche SEMTL et se consacre au génie logiciel pour la société numérique. Pour sa rentrée, nous avons invité chercheur.e.s, étudiant.e.s, partenaires de l'industrie et représentant.e.s des institutions à des conférences invitées du milieu de la recherche comme de l'industrie, suivies d'une table ronde sur la recherche en logiciel pour la société. Ont suivi une présentation de l'histoire et de la portée de SERIQ par Benoit Baudry, des allocutions, puis une réception de réseautage autour d'affiches étudiantes.
Programme
-
15 h 45 – 16 h
Accueil et inscription
Accueil des personnes inscrites.
-
16 h
Mot d'ouverture
Mot de bienvenue et présentation de l'après-midi.
-
16 h 15 – 17 h 30
Conférences invitées
Quatre invité.e.s du milieu de la recherche et de l'industrie exposent chacun.e leur vision de la recherche en logiciel en 15 minutes.
-
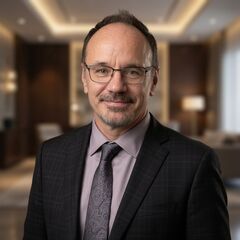
Le logiciel libre comme méthode de recherche : de l'article scientifique à des milliards d'appareils
Résumé
Les bibliothèques libres comme simdjson et simdutf s’exécutent aujourd’hui dans Node.js, les navigateurs et les bases de données, au service de milliards de personnes chaque jour. Le modèle linéaire de l’innovation — le professeur publie, l’ingénieur lit, le client consomme — décrit rarement ce qui se passe vraiment. Comme le rappelait Michael Stonebraker, les idées naissent surtout du contact avec des utilisateurs réels et de leurs problèmes concrets. Le logiciel libre n’est pas seulement un moyen de diffuser des résultats : c’est une méthode de recherche à part entière. Il impose la reproductibilité, puisque le code et les bancs d’essai sont publics et vérifiables par quiconque. Les revues de code, les rapports de bogues et les demandes d’intégration forment une évaluation par les pairs souvent plus exigeante que bien des comités de lecture. Il fait aussi arriver les données du monde réel : cas adversariaux, architectures exotiques et charges de travail imprévues. L’histoire de simdjson inverse l’ordre attendu : d’abord le code, un billet de blogue, GitHub et quelques messages sur X, puis l’adoption industrielle, et seulement ensuite l’article scientifique. Le cycle se répète : l’usage révèle le goulot suivant, d’où l’algorithme Eisel-Lemire pour les flottants et simdutf pour l’UTF-8. Cette approche a toutefois ses tensions : la maintenance est ingrate et sans fin, et les incitatifs académiques comptent les articles, pas les contributions concrètes.
Biographie
Daniel Lemire est professeur d’informatique à l’Université du Québec (TELUQ). Ses travaux de recherche et d’ingénierie portent sur le calcul haute performance, les structures de données efficaces et l’optimisation de la performance logicielle. Il est l’auteur de bibliothèques libres largement adoptées : on trouve ses algorithmes et son code dans plusieurs bibliothèques standards et systèmes majeurs, dont .NET, Rust, Go, Node.js, Google Chrome et Safari. Il figure parmi les 2 % de scientifiques les plus cités au monde selon le classement Université Stanford / Elsevier. Il est rédacteur de la revue Software: Practice and Experience (Wiley, fondée en 1971) et a reçu le Prix d’excellence en recherche 2020 de l’Université du Québec pour ses travaux sur l’accélération du traitement des documents JSON. Sur GitHub, il fait partie des 1000 développeurs les plus suivis parmi plus de 100 millions. Il est @lemire sur X et tient un blogue hebdomadaire à l’adresse https://lemire.me/.
-
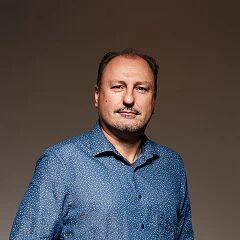
L'IA perturbe votre stratégie de test logiciel, mais elle peut aussi y remédier
Résumé
Les entreprises se livrent à une course effrénée pour intégrer l’IA dans leurs produits, qu’il s’agisse d’assistants basés sur des modèles de langage à grande échelle (LLM), d’agents autonomes ou de fonctionnalités d’apprentissage automatique. Or, les systèmes basés sur l’IA ne se comportent pas comme les logiciels traditionnels. Une même entrée peut produire des résultats différents, la notion de « correct » relève souvent d’un jugement subjectif, et les défaillances peuvent se manifester sous la forme de problèmes de qualité subtils, de biais ou d’« hallucinations », plutôt que par des pannes manifestes. De nombreuses équipes constatent que leurs pratiques de test, leurs indicateurs de performance et leurs critères de validation existants ne leur apportent plus la confiance nécessaire pour livrer leurs produits. Pour la direction, cela se traduit par un risque commercial réel : atteinte à la réputation, risques liés à la conformité et allongement des délais de mise sur le marché.
L’IA offre également une voie à suivre. Bien utilisée, elle peut automatiser une grande partie du travail qui rend l’assurance qualité lente et coûteuse : générer des scénarios de test et des données réalistes, évaluer à grande échelle des résultats ouverts, analyser en continu les systèmes à la recherche de faiblesses et aider les équipes à identifier plus rapidement les causes profondes des défaillances. Il en résulte une couverture plus large, un retour d’information plus rapide et une réduction des coûts d’assurance qualité, tant pour les systèmes basés sur l’IA que pour les logiciels classiques.
Cette conférence offre un regard lucide sur les deux aspects de la question. Pour les dirigeants, elle met en lumière les nouveaux risques liés à la qualité qu’introduit l’IA et ce qu’il faut pour les gérer, notamment en précisant dans quels domaines l’investissement est rentable et où la supervision humaine reste indispensable. Pour les professionnels, elle présente des techniques concrètes et des modèles d’outils permettant de tester les systèmes basés sur l’IA et d’utiliser cette dernière pour renforcer les processus d’assurance qualité existants, tout en soulignant les écueils à éviter, tels que la confiance excessive accordée aux évaluateurs d’IA.
Biographie
Lionel C. Briand est professeur de génie logiciel et occupe des postes partagés à (1) l’Université d’Ottawa, Canada, et (2) au Lero Centre, le centre Research Ireland pour la recherche sur les logiciels, hébergé par l’Université de Limerick. Il est titulaire d’une chaire de recherche distinguée (systèmes logiciels fiables basés sur l’IA) et dirige Lero. Lionel Briand a été élevé aux rangs de IEEE Fellow et ACM Fellow pour ses contributions aux tests et à la vérification de logiciels. Il a reçu le prix Harlan Mills de l’IEEE Computer Society, le prix de recherche exceptionnelle ACM SIGSOFT et le prix de l’ingénieur de l’année de l’IEEE Reliability Society. De plus, il a reçu une ERC Advanced Grant en 2016 pour la modélisation et le test de systèmes cyber-physiques – le prix de recherche individuel le plus prestigieux de l’Union européenne – et a été élu membre de l’Académie des sciences de la Société royale du Canada en 2023, de l’Academia Europaea — l’Académie européenne des sciences, en 2025, et de la première ACM SIGSOFT Software Engineering Academy en 2026.
-
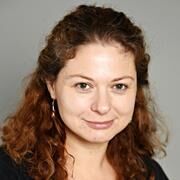
Concevoir la société numérique : de l'intention humaine à des systèmes fiables
Résumé
Les systèmes numériques conditionnent l’accès aux services, la sécurité, la vie privée et les possibilités offertes à chacun. On décrit souvent leurs défaillances comme des bogues, mais beaucoup commencent plus tôt : par des hypothèses restées implicites, des parties prenantes dont les besoins n’ont pas été représentés, ou des composants qui ne fonctionnent pas ensemble comme prévu. Le génie logiciel nous donne les moyens de rendre ces hypothèses explicites, de traduire les besoins humains et sociétaux en exigences de système, et de recueillir des preuves que les systèmes y répondent à mesure qu’ils évoluent. Ce défi devient plus pressant à mesure que l’IA aide à produire du logiciel de plus en plus vite. En m’appuyant sur des exemples tirés des systèmes critiques pour la sûreté et sur mes travaux portant sur les exigences sociales, juridiques, éthiques, empathiques et culturelles, je soutiendrai qu’un logiciel fiable repose sur plus qu’un code correct. Il repose sur un alignement durable entre les systèmes et les personnes qui en dépendent. SERIQ contribuera à bâtir cette capacité par la recherche, la collaboration et la formation de personnes capables de la mettre en pratique.
Biographie
Marsha Chechik est professeure au Département d’informatique de l’Université de Toronto et titulaire de la Chaire universitaire Bell en génie logiciel. Elle a obtenu son doctorat à l’Université du Maryland en 1996.
Elle est l’auteure de plus de 200 articles sur les méthodes formelles, la spécification et la vérification de logiciels, la sûreté et la sécurité informatiques et l’ingénierie des exigences. Ses travaux actuels portent sur l’assurance et la fiabilité du logiciel dans divers domaines, dont l’automobile, la robotique et la santé.
La professeure Chechik a coprésidé le comité de programme de nombreuses conférences internationales de premier plan en génie logiciel, en vérification et en méthodes formelles, dont FM’23, ESEC/FSE’21, ICSE’18, VSTTE’16, TACAS’16, ASE’14, FASE’08 et CONCUR’08. Elle est également rédactrice en chef adjointe des revues International Journal on Software and Systems Modeling et IEEE Transactions on Software Engineering.
La professeure Chechik est Fellow de la communauté Automated Software Engineering, Distinguished Member de l’ACM, membre du groupe de travail IFIP 2.3 sur l’ingénierie des exigences et vice-présidente de l’ACM Special Interest Group on Software Engineering (SIGSOFT).
-
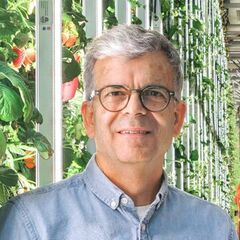
Des cartes perforées aux agents d'intelligence artificielle, comment l'organisation, les coûts et les modèles d'affaires des produits logiciels ont-ils évolué en 40 ans — et pourquoi ce moment est-il différent ?
Résumé
Cette conférence retrace le renversement historique des coûts matériel/main-d’œuvre, la transformation des équipes de développement et l’essor du web, de l’agilité et du cloud comme modèles d’affaires. Elle situe ensuite le tournant de l’assistance IA dans un mouvement plus large. Données à l’appui, elle distingue création de nouveaux produits et maintenance de code déjà maîtrisé, aborde les coûts d’opération des agents IA — sur le nuage comme en local — et conclut par l’émergence de marchés industriels longtemps trop complexes et trop pauvres, qui aujourd’hui se retrouvent en plein bouleversement.
Biographie
Yves Daoust est ingénieur et a fait carrière dans les télécommunications avant de se tourner vers l’agriculture. Il a fondé Ferme d’Hiver en 2018 et l’exploite depuis.
-
-
17 h 30 – 18 h
Pause
Une courte pause avant la table ronde.
-
18 h – 18 h 45
Table ronde
Les conférencières et conférenciers discutent de La recherche en logiciel pour la société : besoins et possibilités.
-
 Daniel Lemire
-
 Lionel Briand
-
 Marsha Chechik
-
 Yves Daoust
-
 Martin Robillard
Animation
-
-
18 h 45 – 19 h 15
Présentation de SERIQ
Benoit Baudry, directeur de SERIQ, en présente l'histoire et la portée. Suivent des allocutions de représentant.e.s des universités :
-
 Frédéric Bouchard, doyen de la Faculté des arts et des sciences, Université de Montréal
-
 Daria Camilla Boffito, directrice associée, recherche et soutien à la recherche, Polytechnique Montréal
-
 Brigitte Pientka, directrice de l'École d'informatique, Université McGill
-
 Alan Carter, doyen de la recherche, ÉTS
-
-
19 h 15 – 20 h
Réception de réseautage
Avec environ 35 affiches de recherche étudiantes.
Accès
Pavillon Jean-Coutu, local S-1-111
2940, chemin de Polytechnique, Montréal (Québec) H3T 1J4
Le pavillon est à quelques minutes à pied de la station de métro Université-de-Montréal (ligne bleue). Pour venir en voiture, l'UdeM décrit le stationnement pour visiteurs et son plan du campus.